

온톨로지 운영 노트 연작 4/4 · (1) 시스템이 바뀌어도 남아야 하는 데이터의 뜻 · (2) 봉제 전용 데이터 사전의 네 가지 작업 · (3) 키 없는 데이터베이스에서 의미를 찾는 방법 · (4) 의미 계층 위에서 AI가 답하게 하는 방법
핵심 요약
자연어 질문을 SQL로 바꾸는 AI는 테이블 이름과 컬럼 이름만 보고 뜻을 추측하기 때문에, 이름은 같고 뜻이 다른 컬럼에서 쉽게 틀립니다. 시제는 도메인별로 필요한 컬럼을 미리 조인한 단일 테이블과 업무 개념 단위의 의미 뷰, 항목별 정의와 제약 조건을 적은 데이터 사전을 먼저 만들고 AI가 그 위에서만 답하도록 설계했습니다. ERP가 바뀌었을 때도 테이블을 새로 맞추기 전에 마스터 정보와 수불 정보 단위로 의미를 다시 연결합니다.
3편의 패션 브랜드가 시제에 요청한 것은 데이터 정리 자체보다 그 다음 단계였습니다. 데이터를 다루지 않는 실무자도 자연어로 질문하면, 단순 조회를 넘어 믿을 수 있는 판매 분석과 타깃 고객 목록을 받아 보는 환경이 목표였습니다.
“지난 시즌 재킷 판매가 가장 많이 줄어든 매장은 어디입니까?”
이런 질문에 AI가 바로 답하게 만드는 일은 생각보다 어렵습니다. 결론부터 말씀드리면 AI가 데이터베이스의 테이블 구조를 직접 추측하게 두면 틀린 답이 나오고 3편에서 만든 의미 계층 위에서 질문에 답하게 해야 결과를 믿을 수 있습니다. 이번 글에서는 그 구조와, 고객사가 ERP를 교체하면서 생긴 연동 문제를 같은 의미 계층으로 다시 연결하는 과정을 정리합니다.
AI가 테이블을 직접 읽으면 생기는 문제
자연어 질문을 데이터베이스 질의문(SQL)으로 바꿔 주는 기술을 Text-to-SQL이라고 부릅니다. 질문을 받은 AI는 테이블과 컬럼 이름을 보고 어떤 테이블을 어떻게 조인할지 정해 질의문을 만듭니다.
문제는 이름만으로는 뜻을 알 수 없는 컬럼이 많다는 점입니다. 3편에서 본 것처럼 반품 건수를 세는 컬럼이 두 개 있고 둘의 갱신 규칙이 다르면, AI는 어느 쪽을 써야 하는지 알 방법이 없습니다. 일부 채널의 확정가가 추정치라는 점도 테이블 어디에도 적혀 있지 않습니다. 질문은 자연스럽게 처리된 것처럼 보이지만 숫자는 틀릴 수 있고 질문한 사람은 그 숫자가 틀렸는지 알아채기 어렵습니다.
신입 사원에게 데이터베이스 접속 권한만 주고 매출 보고서를 만들라고 하는 상황과 같습니다. 사내 용어와 계산 규칙을 모르는 상태에서는 성실하게 작업해도 기준이 다른 숫자가 나옵니다.
의미 계층 위에서 답하게 하는 세 가지 장치
시제가 고객사에 제안한 방법은 AI에게 테이블을 직접 주지 않고 업무 개념으로 정리된 층을 그 사이에 두는 방식입니다.
| 장치 | 하는 일 | 적용 시점 |
|---|---|---|
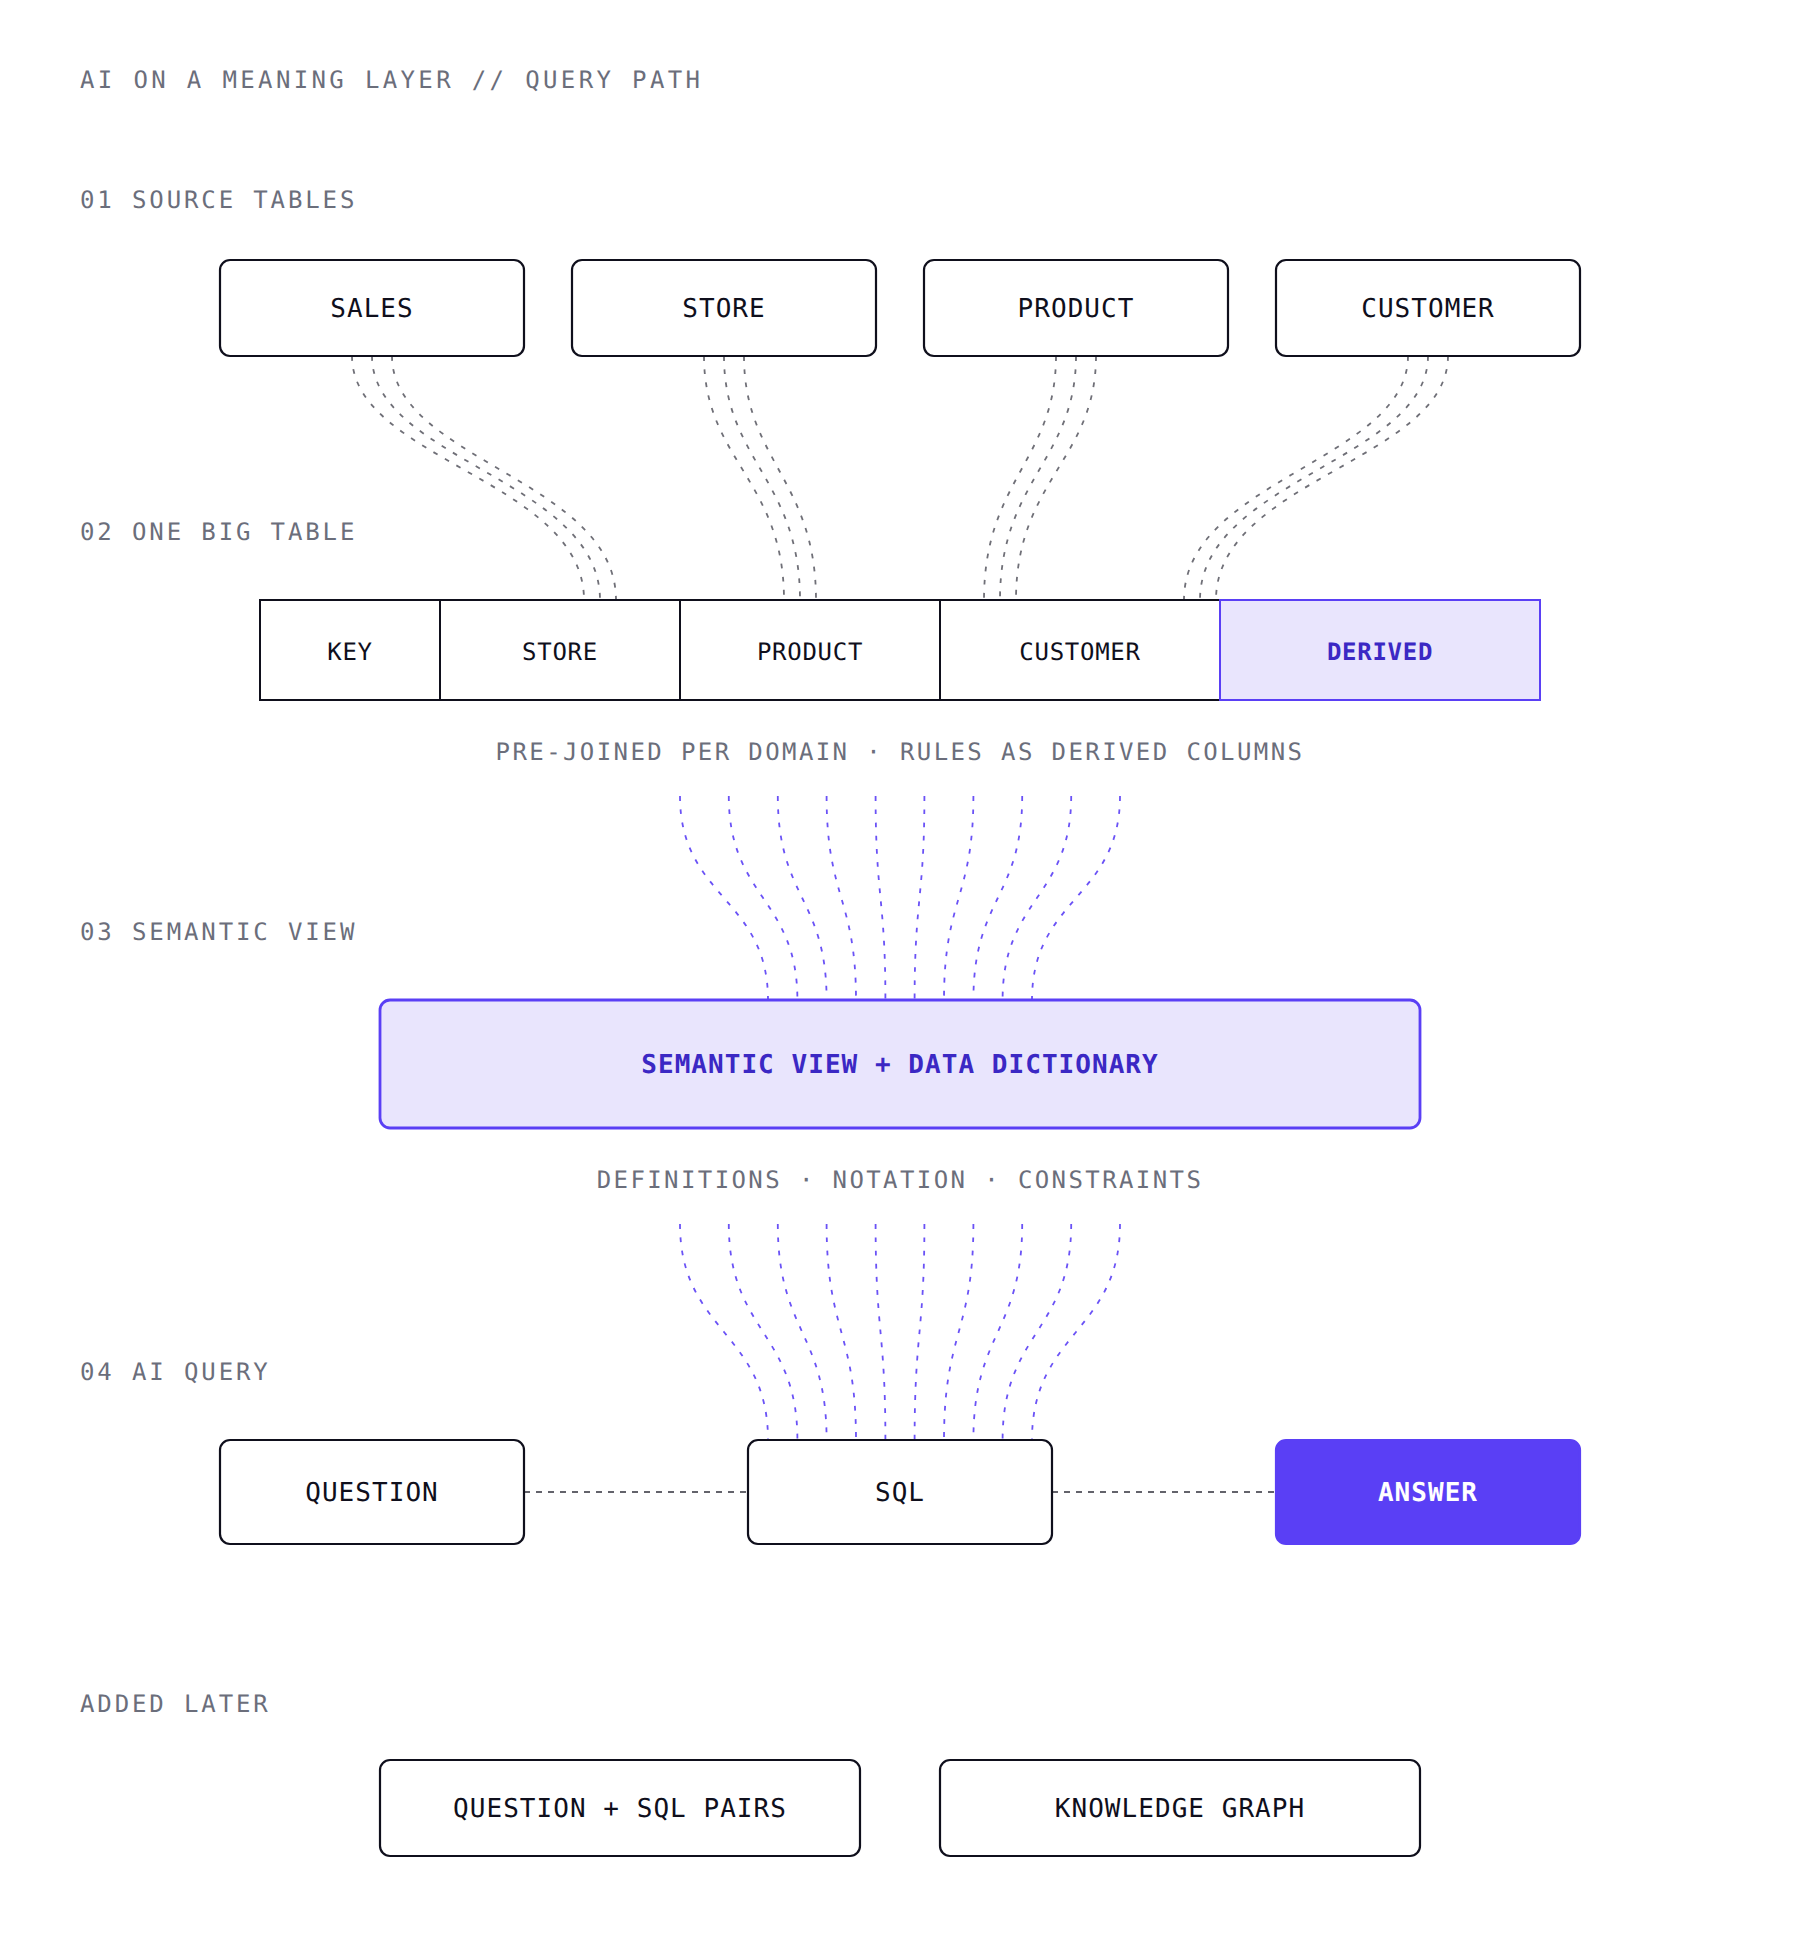
| 의미 뷰와 데이터 사전 | 수불·판매·고객 테이블을 업무 개념 단위로 묶은 뷰를 만들고 항목마다 정의와 표기, 제약 조건1을 적어 AI가 컬럼을 잘못 연결하지 않게 함 | 단기 |
| 질문과 질의문 예시 | 자주 쓰는 질문과 그에 맞는 표준 질의문을 쌍으로 저장해 두고 비슷한 질문이 들어오면 참고 예시로 제시 | 중장기 |
| 지식 그래프 | 고객·수불·판매 사이의 관계를 노드와 관계로 표현해2 여러 단계를 따라가야 하는 질문에 답하게 함 | 중장기 |
세 장치 모두 AI가 추측해야 하는 범위를 줄이는 방향입니다. 정의가 적혀 있으면 AI는 이름을 보고 뜻을 짐작하지 않고 적혀 있는 정의를 근거로 질의문을 만듭니다.
도메인별 단일 테이블
의미 뷰 아래에는 도메인별 단일 테이블(OBT, One Big Table)을 둡니다. 판매 분석에 필요한 판매·매장·상품·고객 컬럼을 미리 조인해 한 행에 모아 둔 테이블입니다.
장보기 목록에 비유할 수 있습니다. 요리할 때마다 냉장고와 찬장과 마트를 오가며 재료를 모으는 대신, 자주 하는 요리에 필요한 재료를 미리 한 바구니에 담아 두는 방식입니다. 조인이 미리 끝나 있으므로 AI가 조인 경로를 잘못 고를 일이 줄고 3편에서 꺼낸 계산 규칙(확정가 추정, 반품 판정 기준)은 이 테이블을 만들 때 파생 컬럼으로 미리 계산해 둡니다.
| 설계 항목 | 내용 |
|---|---|
| 행의 기준 | 테이블마다 고유 키를 정하고 고유 키 값이 갱신되면 하위 컬럼을 모두 조인해 한 행으로 다시 가져옴 |
| 파생 컬럼 | 기존 보고서 수식을 옮겨 확정가, 반품 구분 같은 값을 미리 계산 |
| 조회 범위 | 3편의 합의(폐점 매장 포함, 확정분과 잠정분 구분)를 컬럼과 조건으로 반영 |
| 검증 자료 | 실제 데이터로 만든 샘플 행과, 이 테이블로 답할 수 있는 자연어 질문 예시를 같이 전달 |
데이터 보관 방식도 이 목적에 맞췄습니다. 기존 데이터베이스의 테이블을 열 단위로 압축하는 파일 형식(Parquet)으로 바꿔 클라우드 저장소에 적재했고 그 위에서 분석용 데이터 플랫폼이 읽도록 연결했습니다. 보존과 분석이 목적이므로 상시 운영 비용이 드는 데이터베이스 서버를 따로 두지 않았습니다.
ERP가 바뀌었을 때
고객사는 이 작업과 별도로 기존 ERP를 새 제품으로 교체하는 중이었습니다. 시제가 정리한 핵심 테이블 명세를 고객사가 새 ERP 업체에 전달했는데, 새 ERP 업체는 관리 항목 체계가 기존 데이터베이스 구조와 달라 그 명세로는 연동할 수 없다고 회신했습니다. 새 ERP는 데이터베이스 스키마도 별도로 제공하지 않았습니다.
1편 첫머리의 상황이 실제로 생겼습니다. 이때 테이블 구조부터 맞추려 하면 새 ERP의 테이블을 하나하나 추측해야 합니다. 시제는 순서를 바꿔 의미부터 다시 연결했습니다.
| 순서 | 하는 일 |
|---|---|
| 1 | 새 ERP 화면에 표시되는 컬럼을 판매·상품 같은 도메인별로 모두 받음 |
| 2 | 받은 컬럼 이름을 기존 의미 계층의 정의와 먼저 대조(실제 값 없이 이름과 설명 기준) |
| 3 | 마스터 정보(상품, 거래처)와 수불 정보(물류: 입고·출고·이동·타계정·재고 / 매장: 입점·반품·R/T·타계정·판매·재고) 단위로 연동 항목을 다시 정의 |
| 4 | 마진, 할인율, 쿠폰, 마일리지처럼 이관 과정에서 빠지기 쉬운 속성을 따로 확인 |
| 5 | 주문에서 재고까지 이어지는 흐름을 기준 관점으로 삼아 연동 범위를 확정 |
1번에서 4번까지는 새 시스템의 테이블 구조를 몰라도 진행할 수 있습니다. 상품·거래처·입고·판매·반품·재고 같은 업무 개념과 그 정의가 이미 의미 계층에 정리돼 있으므로, 새 ERP의 컬럼이 그중 어디에 해당하는지만 찾으면 됩니다. 의미 계층 위에 만든 단일 테이블과 의미 뷰, AI 질의 구조는 이 연결만 바뀌고 그대로 쓰입니다.

연작을 마무리하며
네 편에 걸쳐 시제가 온톨로지로 데이터 시스템을 운영하는 방식을 정리했습니다. 1편에서는 데이터의 뜻을 시스템과 분리해 정의해야 하는 이유와 공개된 온톨로지 기술을, 2편에서는 봉제 공정 데이터에 표준공정 47,359종의 사전을 만든 과정을, 3편과 4편에서는 패션 브랜드의 판매 데이터에서 의미를 복원하고 그 위에 AI 질의 구조를 만든 과정을 다뤘습니다.
봉제 공장의 공정 데이터와 브랜드의 판매 데이터는 내용이 다르지만 다룬 순서는 같았습니다. 개념을 먼저 정의하고 숨은 규칙을 꺼내 문서로 남기고 그 정의 위에서 계산과 AI 질의가 이뤄지게 했습니다. 이렇게 남긴 정의서와 규칙 문서는 다음에 시스템을 교체할 때 연동 항목을 다시 정의하는 기준이 됩니다.
👉 온톨로지 운영 노트 (1) : 시스템이 바뀌어도 남아야 하는 데이터의 뜻
👉 온톨로지 운영 노트 (2) : 봉제 전용 데이터 사전의 네 가지 작업
👉 온톨로지 운영 노트 (3) : 키 없는 데이터베이스에서 의미를 찾는 방법
봉제 생산 용어 노트
Text-to-SQL
자연어 질문을 데이터베이스 질의문(SQL)으로 바꾸는 기술입니다.
의미 뷰(Semantic View)
여러 테이블을 업무 개념 단위로 묶고 항목마다 뜻을 붙여 둔 조회용 구조입니다.
단일 테이블(OBT, One Big Table)
분석에 필요한 컬럼을 미리 조인해 한 행에 모아 둔 테이블입니다.
파생 컬럼
원래 데이터에는 없고 계산 규칙으로 만들어 넣은 컬럼입니다.
마스터 정보
상품, 거래처처럼 거래의 기준이 되는 정보입니다.
수불 정보
입고·출고·판매·반품처럼 재고를 늘리거나 줄이는 거래 기록입니다.
참고 자료
- W3C, OWL 2 Web Ontology Language Primer (Second Edition), 2012. 클래스 계층과 제약 조건. ↩
- W3C, RDF 1.1 Concepts and Abstract Syntax, 2014. 지식 그래프의 기본 단위인 트리플의 정의. ↩
