

온톨로지 운영 노트 연작 1/4 · (1) 시스템이 바뀌어도 남아야 하는 데이터의 뜻 · (2) 봉제 전용 데이터 사전의 네 가지 작업 · (3) 키 없는 데이터베이스에서 의미를 찾는 방법 · (4) 의미 계층 위에서 AI가 답하게 하는 방법
핵심 요약
테이블은 데이터를 담는 그릇입니다. 그 값이 업무에서 무엇을 뜻하는지는 테이블 바깥에 따로 정의해야 시스템을 바꿔도 남습니다. 온톨로지는 개념(클래스), 개별 대상(인스턴스), 값(속성), 연결(관계)으로 이 정의를 적는 방법이고 RDF·OWL·SWRL 같은 공개 표준으로 컴퓨터가 읽을 수 있게 표현합니다. 시제는 업무 개념을 먼저 정의하고 보고서와 엑셀 속에 숨은 계산 규칙을 문서로 꺼낸 뒤, AI가 그 정의를 기준으로 답하도록 데이터 시스템을 운영합니다.
ERP를 바꾸는 회사가 실제로 부딪히는 문제가 있습니다. 기존 데이터베이스의 테이블 명세를 새 ERP 업체에 넘기면, 관리 항목의 이름과 단위가 서로 달라 그 명세로는 연동할 수 없다는 답이 돌아옵니다. 그때부터 실무자는 이런 질문을 받습니다.
“테이블 이름은 바뀌었는데, 우리 회사의 반품은 예전과 같은 반품입니까?”
결론부터 말씀드리면 바뀌는 것은 데이터를 저장하는 방식입니다. 상품·거래처·입고·판매·반품·재고 같은 업무 개념과 그 정의는 그대로 남아야 합니다. 이 정의를 특정 시스템의 테이블과 분리해 따로 관리하는 방법이 온톨로지이며 시제는 데이터 시스템을 이 방식으로 운영합니다. 이번 연작에서는 공개된 온톨로지 기술을 먼저 정리하고 시제가 이를 봉제 데이터와 고객사 데이터에 적용한 과정을 네 편에 나눠 다룹니다.
테이블과 의미의 차이
테이블은 행과 열로 데이터를 담는 그릇입니다. 같은 업무 개념이라도 시스템마다 담는 방식이 다를 수 있습니다. 아래는 반품을 다루는 두 가지 방식을 비교한 예시입니다.
| 구분 | 시스템 A | 시스템 B |
|---|---|---|
| 반품 저장 방식 | 원래 판매 전표에 반품 여부를 표시 | 반품 전표를 따로 생성 |
| 반품 건수를 세는 방법 | 반품 여부가 Y인 판매 전표를 셈 | 반품 전표를 셈 |
| 교환 처리 | 별도 구분 없음 | 반품 전표와 판매 전표를 연결 |
※ 설명을 위한 예시입니다.
두 시스템에서 나온 반품 건수를 나란히 놓으려면 “반품이란 어떤 거래를 말하는가”, “교환은 반품에 포함하는가”를 먼저 정해 두어야 합니다. 이 정의가 담당자의 기억이나 보고서 수식 안에만 있으면, 시스템을 바꾸는 순간 정의도 같이 사라지고 새 시스템에서 처음부터 다시 맞춰야 합니다.
지번 주소가 도로명 주소로 바뀌었을 때를 떠올리면 이해가 쉽습니다. 건물은 그 자리에 그대로 있었고 바뀐 것은 건물을 찾아가는 표기 체계였는데, 우편물과 등기와 택배 시스템은 모두 새 표기를 기존 건물에 다시 연결해야 했습니다. 데이터도 같은 구조입니다. 업무 개념이 건물이고 테이블과 컬럼 이름이 주소 표기라서, 건물 목록을 따로 관리해 두어야 주소 체계가 바뀌어도 다시 연결할 수 있습니다.
온톨로지의 정의와 구성 요소
온톨로지는 한 분야에서 쓰는 개념과 개념 사이의 관계를 사람들이 합의한 대로 정리하고 컴퓨터가 읽을 수 있는 형식으로 적어 둔 모델입니다.12 학계 정의와 지하철 노선도 비유는 Knowledge AI 연작 마지막 글 「측정한 값이 회사의 자산이 되기까지」에서 다뤘으므로, 여기서는 의류 공급망 데이터에 대응시킨 표만 정리합니다.
| 요소 | 정의 | 의류 공급망의 예 |
|---|---|---|
| 클래스(Class) | 성격이 같은 대상을 묶은 범주 | 원단, 스타일, 공정, 거래처 |
| 인스턴스(Instance) | 클래스에 속한 개별 대상 | 원단 롤 한 개, 스타일 번호 한 개 |
| 속성(Property) | 대상에 붙는 값 | 원단 폭, 혼용률, 공정 표준시간 |
| 관계(Relation) | 대상과 대상을 잇는 연결 | 스타일이 원단을 사용한다, 공정이 부위에 속한다 |
속성은 다시 두 가지로 나뉩니다. 원단 폭이 58인치라는 것처럼 대상에 숫자나 글자를 붙이는 것을 데이터 속성이라고 합니다. 스타일이 특정 원단을 사용한다는 것처럼 대상과 대상을 잇는 것을 관계 속성이라고 합니다.4 표의 관계(Relation)가 이 관계 속성에 해당합니다.
관계의 두 종류
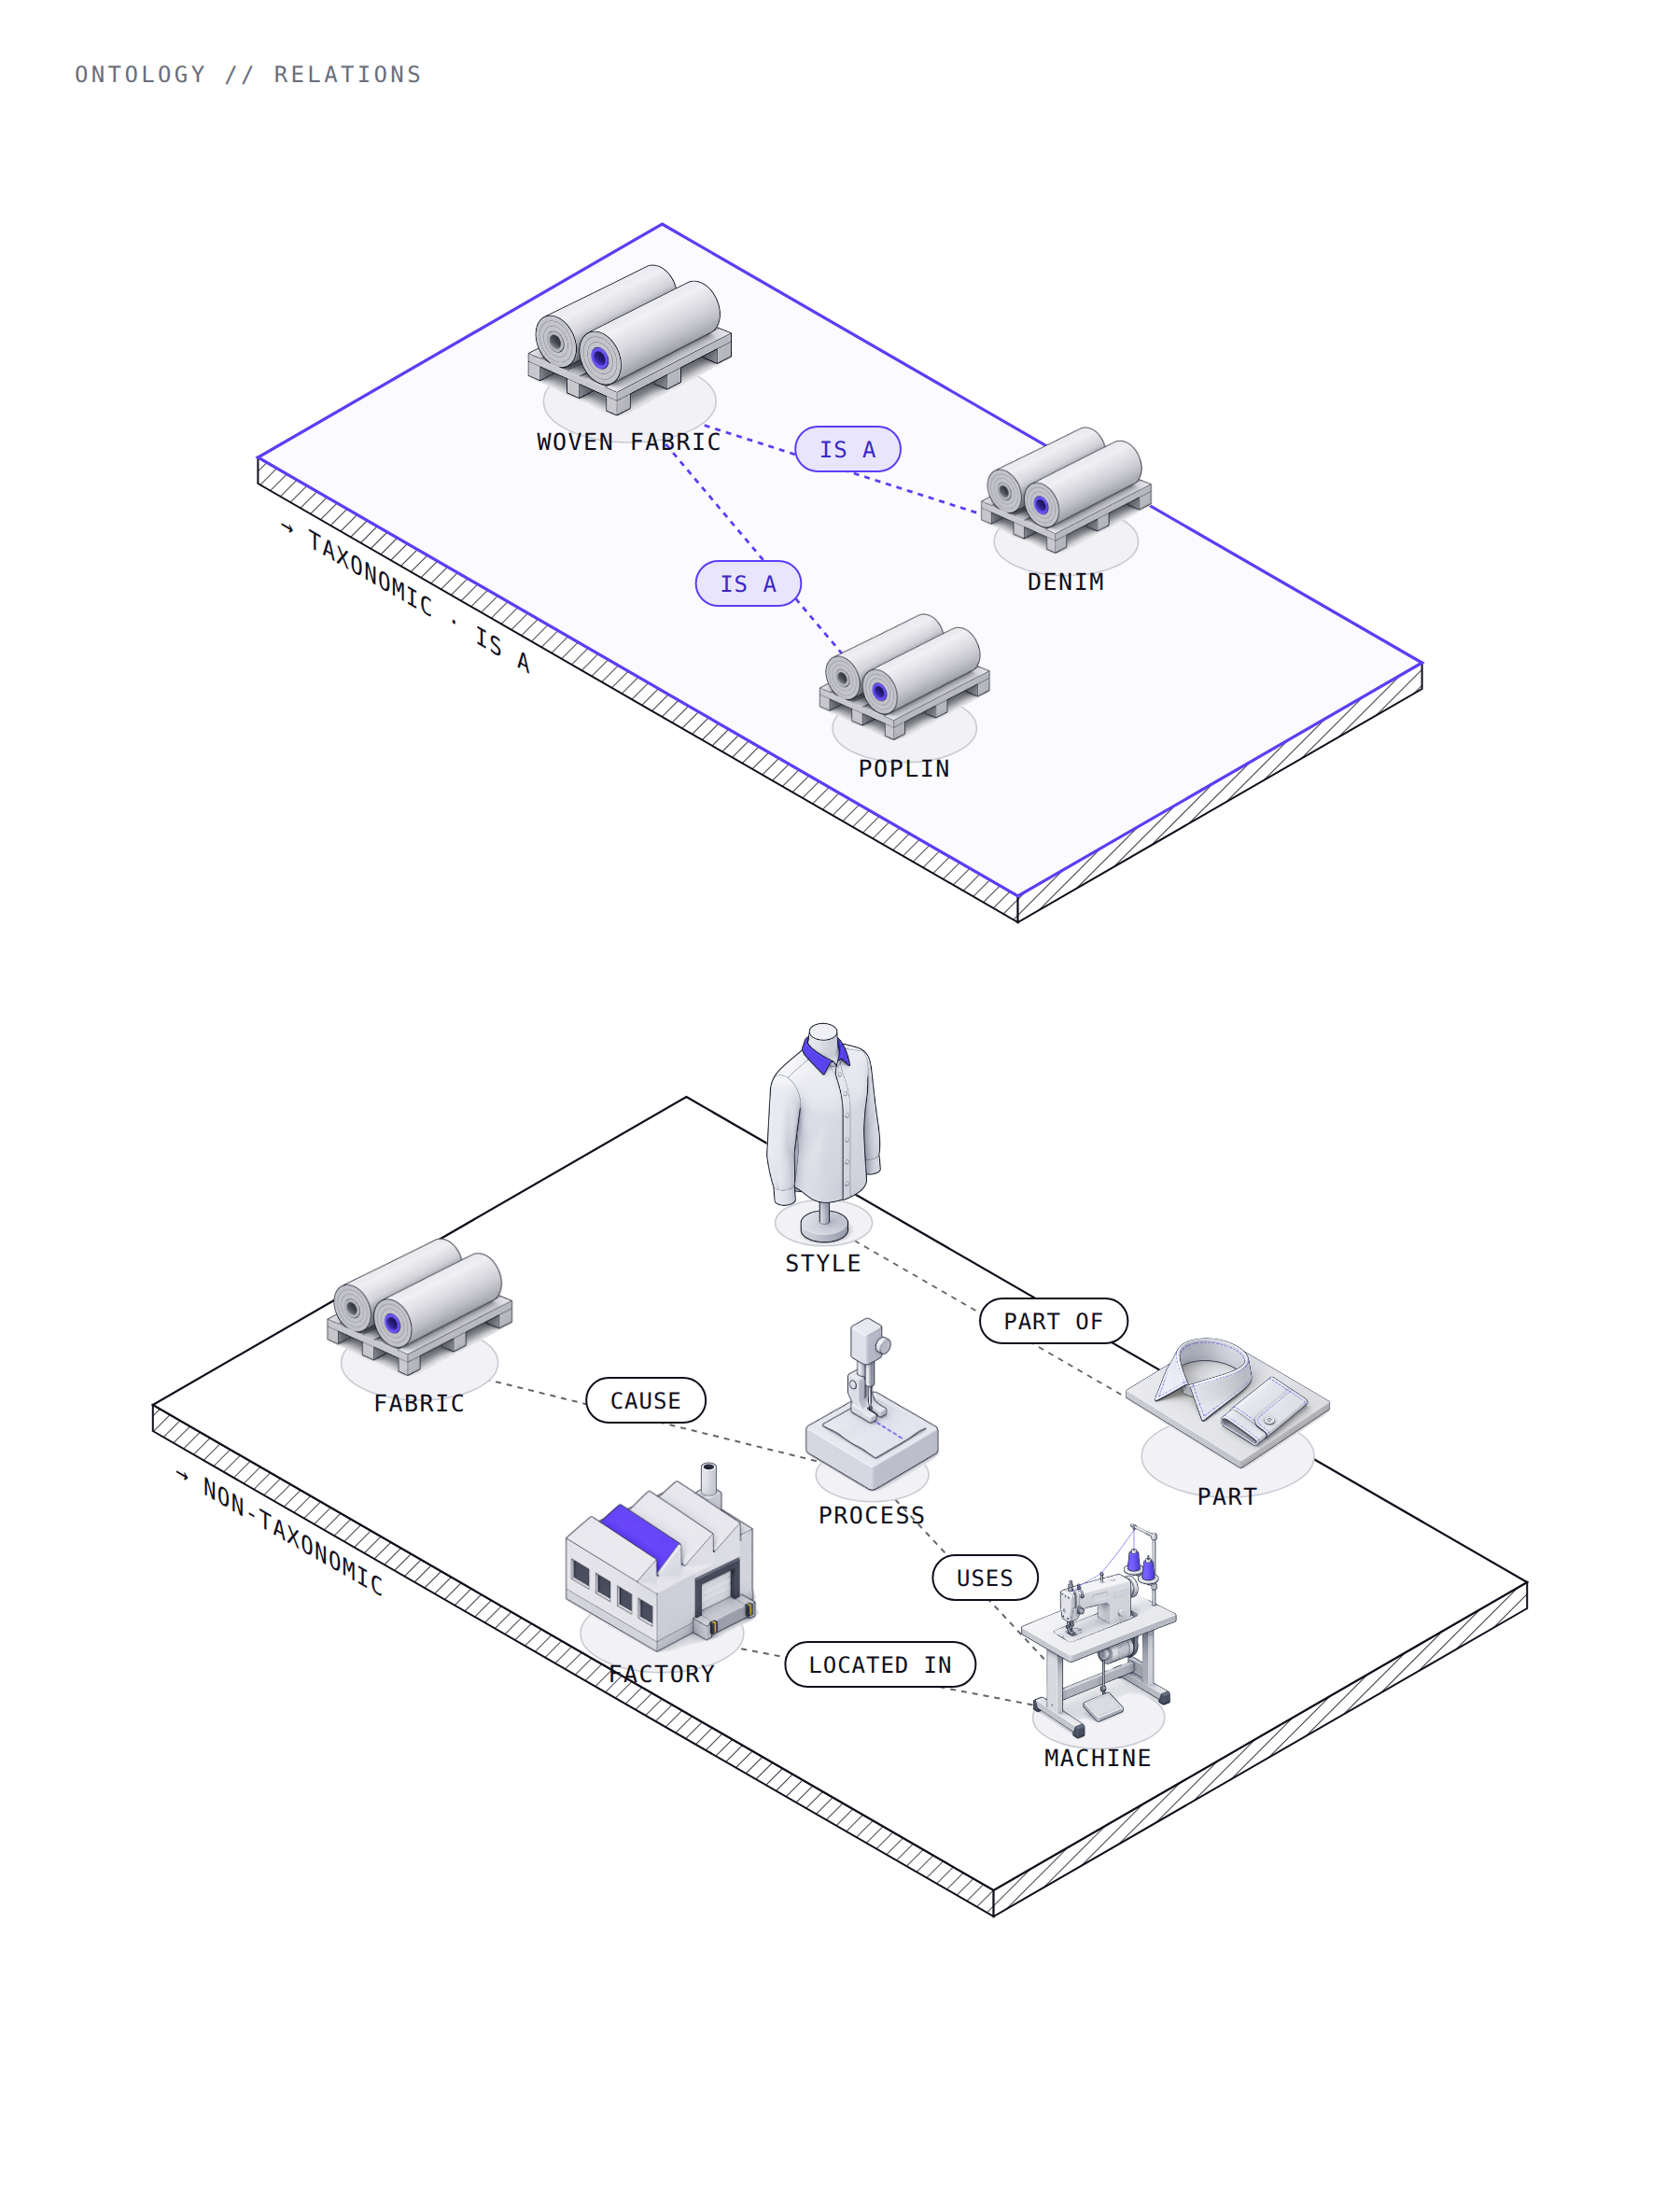
관계는 분류 관계와 비분류 관계로 나뉩니다. 분류 관계는 “A는 B의 한 종류다”를 뜻하는 상하위 관계로, 흔히 isA로 표기합니다. 비분류 관계는 그 밖의 모든 연결로, 부분을 뜻하는 partOf, 위치를 뜻하는 locatedIn, 원인을 뜻하는 cause가 대표적입니다.
| 관계 | 의류 공급망의 예 | 데이터에서 쓰이는 곳 |
|---|---|---|
| isA (분류) | 데님은 우븐 원단의 한 종류 | 원단이 부족할 때 같은 상위 분류 안에서 대체 후보를 찾음 |
| partOf (부분) | 칼라는 셔츠의 부위 | 부위별 공정과 자재를 모아 원가를 계산 |
| locatedIn (위치) | 생산 라인은 공장에 속함 | 라인 실적을 공장 단위 생산능력으로 집계 |
| cause (원인) | 재단 지연이 봉제 투입 지연을 일으킴 | 납기 지연의 원인을 거슬러 추적 |
※ 관계 예시는 설명을 위해 단순화했습니다.
분류 관계만 있으면 잘 정리된 목록이 되고 비분류 관계가 더해져야 “이 원단이 늦으면 어떤 오더의 어느 공정이 밀리는가” 같은 질문에 답할 수 있습니다. 관계를 몇 단계 따라가는 질문이 많을수록 테이블 조인 대신 관계 중심으로 데이터를 정리하는 쪽이 유리합니다.
의미를 적는 표준: RDF, OWL, SWRL
정의를 사람만 읽는 문서로 남기면 컴퓨터는 쓰지 못합니다. 그래서 웹 표준 기구 W3C는 개념과 관계를 기계가 읽는 형식으로 적는 언어를 공개해 두었습니다. 대표적인 것이 RDF·OWL·SWRL 세 가지입니다.
RDF(Resource Description Framework)는 모든 사실을 주어, 서술어, 목적어의 세 칸으로 적는 형식입니다. 이 세 칸 묶음을 트리플이라고 부릅니다.3 문장을 “누가 무엇을 어떻게 한다”로 쪼개 적는다고 생각하면 됩니다.
(스타일 #S)   --사용한다-->   (원단 #F)
(원단 #F)     --분류-->       (데님)
(데님)        --하위분류-->   (우븐 원단)
※ #S, #F는 설명용 가상 번호입니다.
OWL(Web Ontology Language)은 RDF 위에 클래스의 상하위 구조와 제약 조건을 적는 언어입니다.4 제약 조건은 데이터가 반드시 지켜야 하는 조건으로, 예를 들어 “모든 반품 전표는 원래 판매 전표를 가리켜야 한다”를 적어 두면 판매 전표가 연결되지 않은 반품 전표를 자동으로 찾아낼 수 있습니다.
SWRL(Semantic Web Rule Language)은 “조건이 맞으면 이렇게 판단한다”는 규칙을 적는 언어입니다.5 현장에서 담당자가 머릿속으로 내리는 판단을 조건과 결론으로 나눠 적는 방식입니다.
조건: 오더의 납기까지 남은 일수 < 남은 생산 소요 일수
결론: 오더 상태 = 납기 위험
※ 규칙 형식을 보여 주기 위한 예시입니다.
세 언어의 역할을 나누어 보면 RDF는 사실을, OWL은 구조와 제약을, SWRL은 판단 규칙을 적는 데 쓰입니다.
데이터·로직·액션의 세 층
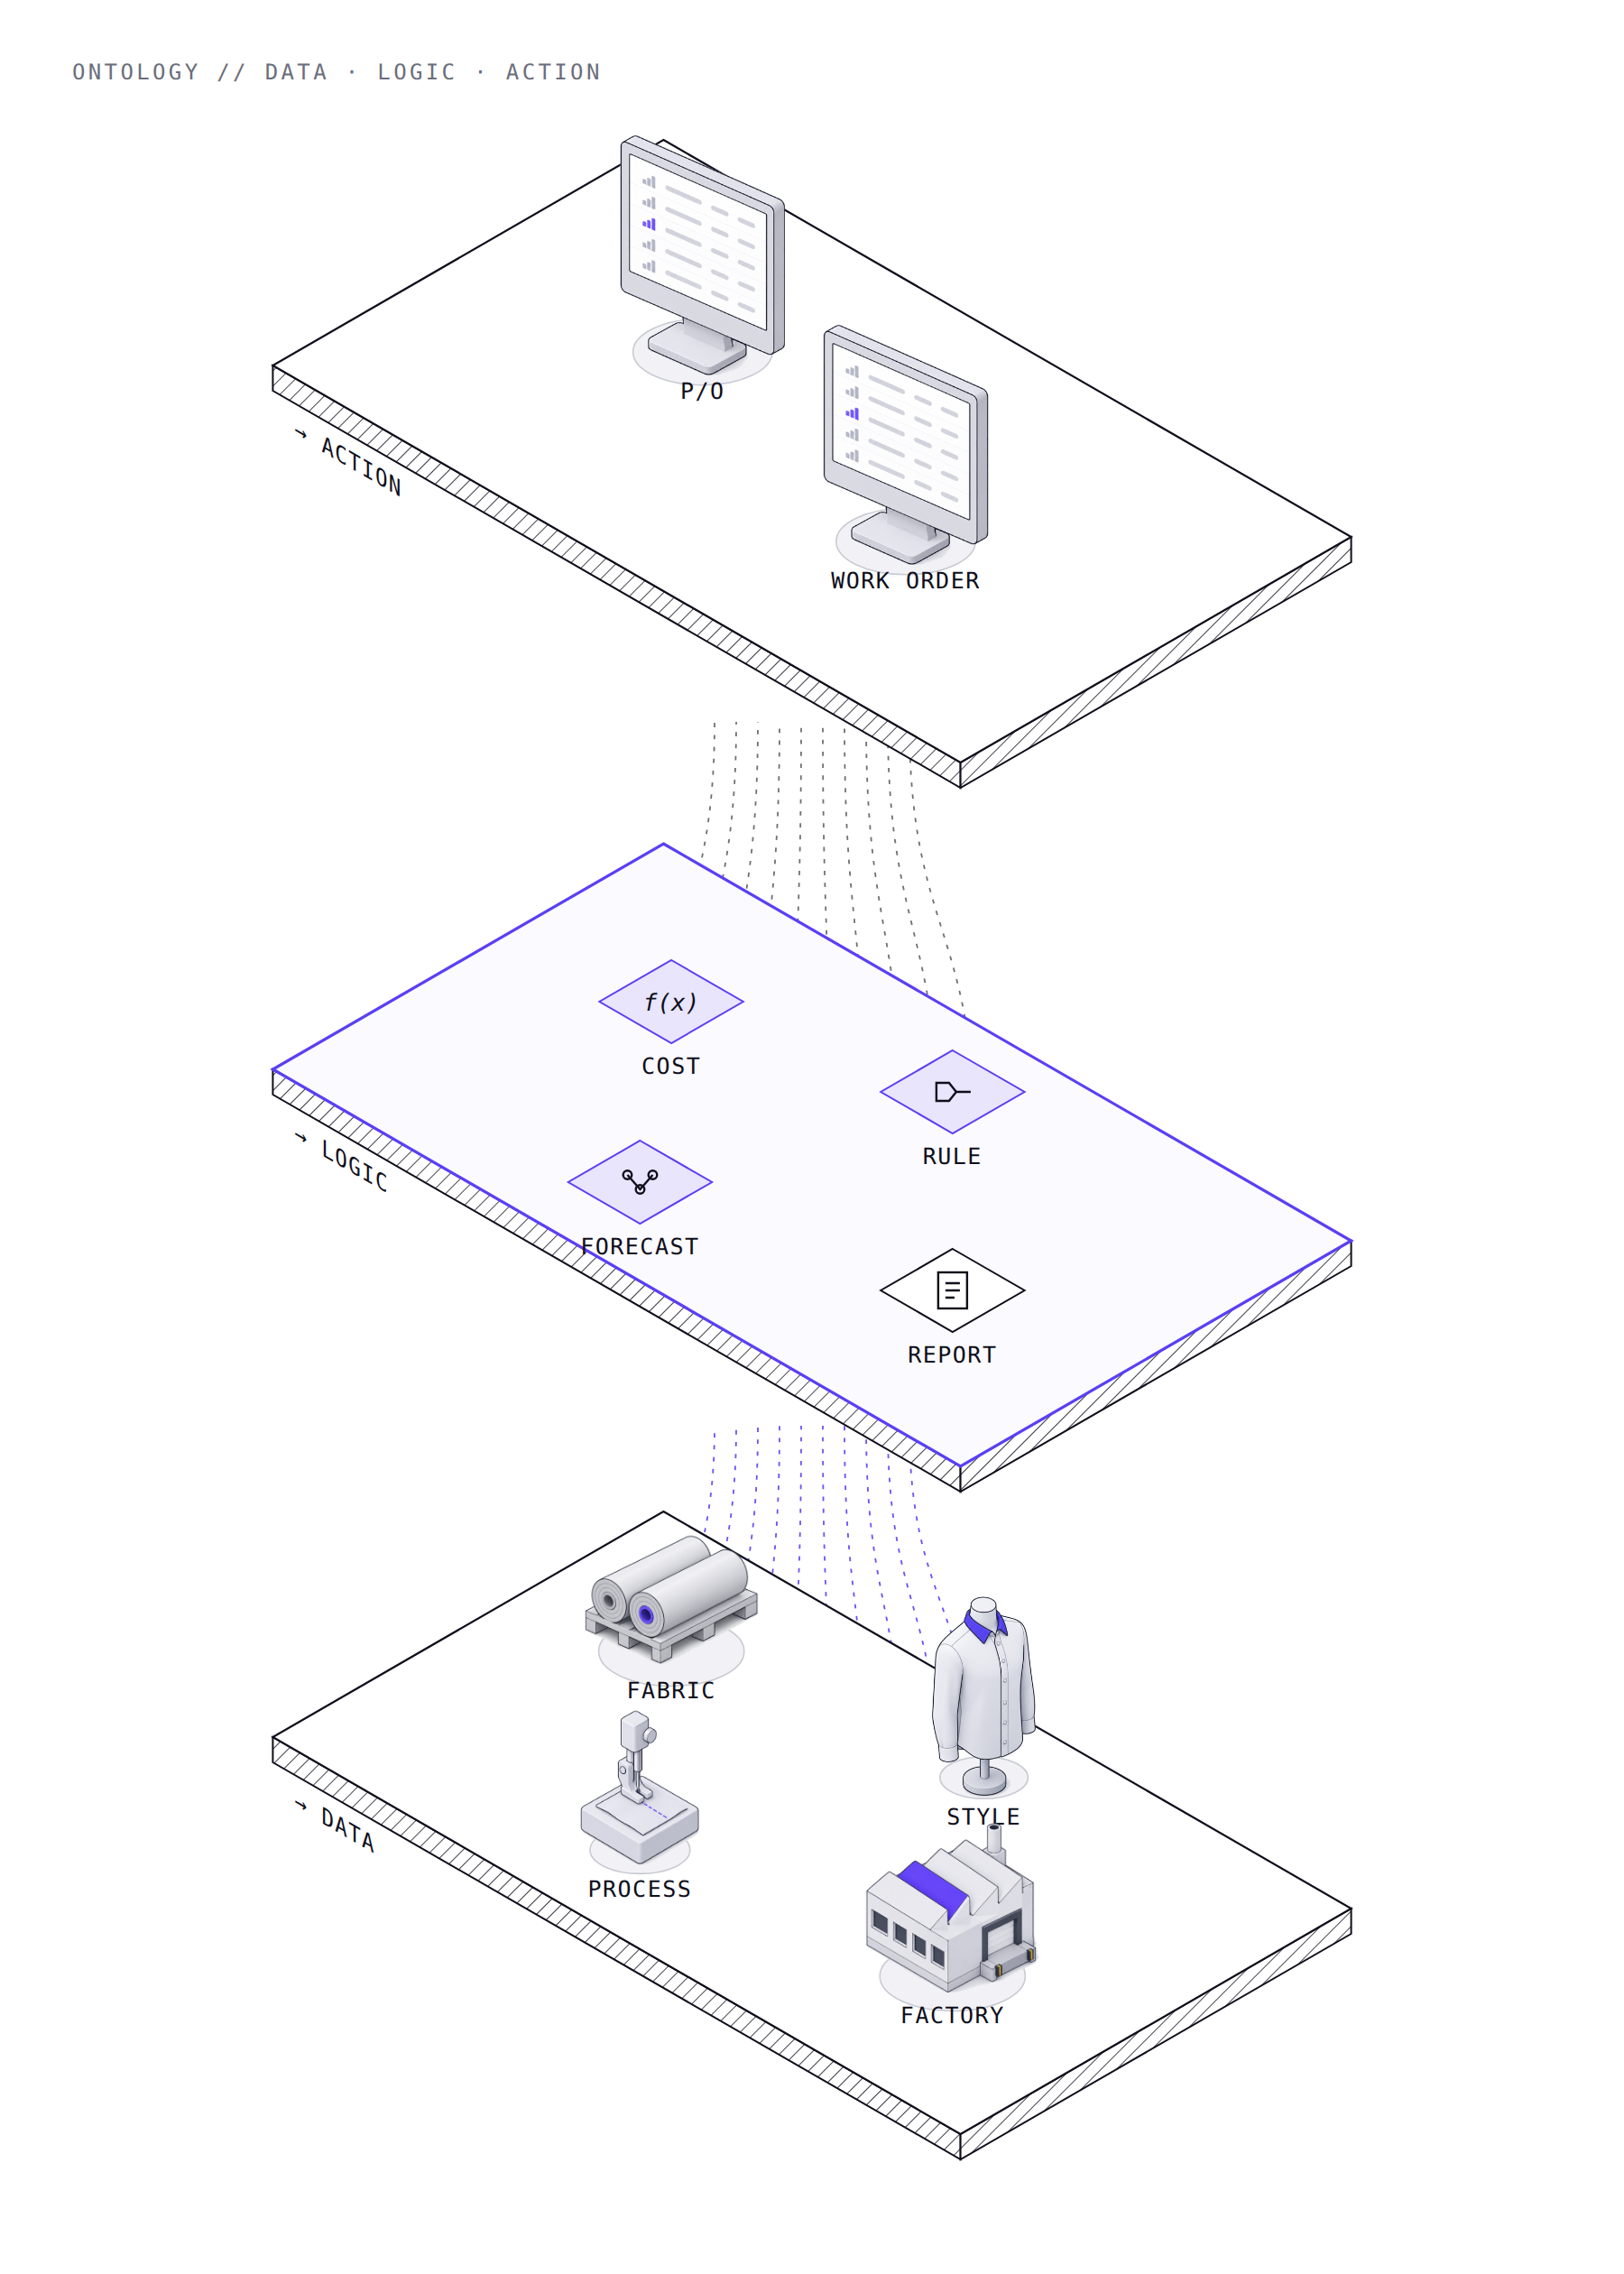
온톨로지로 데이터 시스템을 운영할 때는 정의할 대상을 세 층으로 나눠 봅니다.
| 층 | 담는 것 | 의류 공급망의 예 |
|---|---|---|
| 데이터 | 대상과 속성, 관계 | 오더, 스타일, 원단, 공정, 재고 |
| 로직 | 계산식, 판단 규칙, 예측 모델 | 원가 계산식, 납기 위험 규칙, 생산량 예측 |
| 액션 | 판단 결과를 업무 시스템에 반영하는 행위 | 발주서 생성, 작업지시 변경, 라인 재배치 |
데이터 층만 정의하고 로직을 보고서 수식이나 엑셀 매크로, 담당자의 경험 속에 남겨 두면 시스템을 바꿀 때 계산 결과가 달라져도 원인을 찾기 어렵습니다. 로직을 정의된 대상과 연결해 문서로 관리해야 같은 데이터에서 같은 판단이 나오고 그 판단을 액션으로 옮길 때도 근거를 추적할 수 있습니다.
시제가 데이터 시스템을 운영하는 방식
시제는 이 기술을 네 가지 원칙으로 데이터 시스템 운영에 적용합니다.
| 원칙 | 하는 일 |
|---|---|
| 개념을 먼저 정의 | 고객 시스템의 테이블 이름보다 상품·거래처·입고·출고·판매·반품·재고 같은 업무 개념과 그 뜻을 먼저 정리합니다 |
| 숨은 규칙을 꺼냄 | 보고서 수식과 엑셀 안에 들어 있는 계산 규칙을 찾아 규칙 문서로 옮기고 그 의미를 고객과 확인합니다 |
| 정의서를 남김 | 소프트웨어와 별도로 데이터 규칙 정의서를 산출물로 남겨, 시스템을 바꿔도 정의가 회사에 남게 합니다 |
| 정의 위에서 AI가 답함 | AI가 테이블 구조를 추측하지 않고 정의된 개념과 규칙을 기준으로 질문에 답하게 설계합니다 |
네 번째 원칙의 근거는 단순합니다. 문서와 데이터에 담긴 정보의 의미와 맥락, 구체적인 속성을 미리 정의해 두면, AI는 어떤 정보가 들어올지 알고 있는 상태에서 문서를 읽기 때문에 엉뚱한 컬럼을 엉뚱한 개념으로 연결하는 일이 줄어듭니다.
이 원칙을 봉제 공정 데이터에 적용한 결과가 시제의 봉제 전용 데이터 사전입니다. 지금까지 이 사전에 표준공정 47,359종을 정리했습니다. 다음 편에서는 이 사전을 만드는 네 가지 작업(공정명 정규화, 설비 매핑, 스타일 좌표화, 표제어별 통계 부여)을 다룹니다.
👉 온톨로지 운영 노트 (2) : 봉제 전용 데이터 사전의 네 가지 작업
봉제 생산 용어 노트
온톨로지(Ontology)
한 분야의 개념과 개념 사이의 관계를 합의된 대로 정리해 컴퓨터가 읽을 수 있게 적은 모델입니다.
클래스(Class) / 인스턴스(Instance)
성격이 같은 대상을 묶은 범주 / 그 범주에 속한 개별 대상입니다.
데이터 속성 / 관계 속성
대상에 값을 붙이는 속성 / 대상과 대상을 잇는 속성입니다.
분류 관계(isA)
“A는 B의 한 종류다”를 뜻하는 상하위 관계입니다.
트리플(Triple)
주어, 서술어, 목적어의 세 칸으로 사실을 적는 RDF의 기본 단위입니다.
제약 조건(Constraint)
데이터가 반드시 지켜야 하는 조건으로, 위반한 데이터를 찾아내는 기준이 됩니다.
참고 자료
- Thomas R. Gruber, A Translation Approach to Portable Ontology Specifications, Knowledge Acquisition 5(2), 199~220, 1993. 온톨로지를 개념화의 명시적 명세로 정의. ↩
- Rudi Studer, V. Richard Benjamins, Dieter Fensel, Knowledge Engineering: Principles and Methods, Data & Knowledge Engineering 25, 1998. 온톨로지를 여러 사람이 합의한 “공유된 개념화”로 본 정의. ↩
- W3C, RDF 1.1 Concepts and Abstract Syntax, 2014. 주어, 서술어, 목적어로 이루어진 트리플의 정의. ↩
- W3C, OWL 2 Web Ontology Language Primer (Second Edition), 2012. 클래스 계층, 데이터 속성과 관계 속성, 제약 조건. ↩
- W3C, SWRL: A Semantic Web Rule Language Combining OWL and RuleML, W3C Member Submission, 2004. 조건과 결론으로 이루어진 규칙 표현. ↩
